Hardware
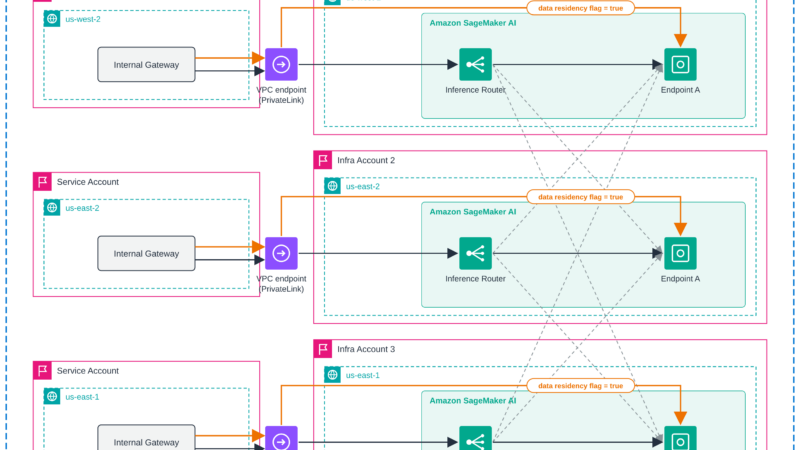
Amazon estrena enrutado de inferencia entre regiones en SageMaker AI
Amazon introduce en SageMaker AI un inference router que da un unico punto de invocacion sobre endpoints de varias regiones y cuentas.
6 min
Hardware de inteligencia artificial: chips, GPU, centros de datos y energia. Nvidia, AMD, TPU y el hardware que hace posible entrenar y servir IA a gran escala.
Amazon introduce en SageMaker AI un inference router que da un unico punto de invocacion sobre endpoints de varias regiones y cuentas.
HyperPod incorpora observabilidad ampliada que cubre las capas de GPU, red y host en clústeres EKS y Slurm.
NVIDIA publicó Run:ai como código abierto el 13 de octubre de 2026; AWS desglosa su uso en Amazon EKS.
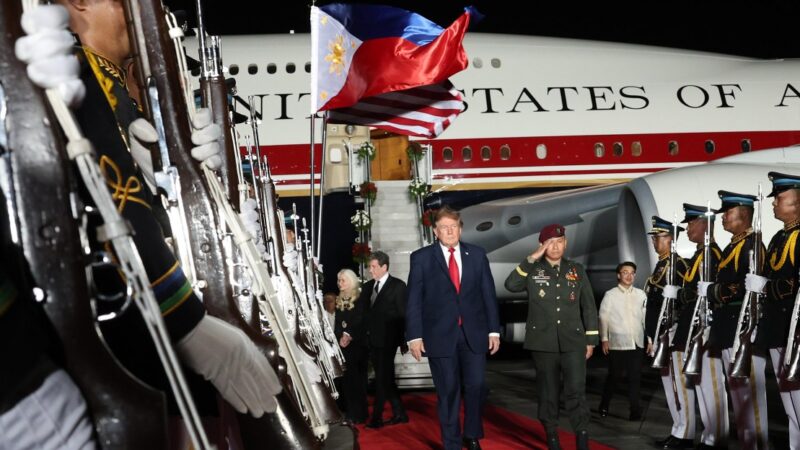
Estados Unidos y Filipinas preparan un hub de 1.620 hectáreas (4.000 acres) sobre la antigua base de Clark para chips, minerales críticos y centros de datos, bajo el marco Pax Silica.
NVIDIA ha dejado de enviar sus chips de IA más potentes a China, y lo hace pese a que la Casa Blanca le había concedido permiso para hacerlo el diciembre pasado.
Durante el verano de 2026 el sector de la IA vivió un momento insólito: los propios creadores de los modelos más potentes pedían frenar.
El buscador semántico Exa, que indexa.
Amazon ha publicado en su blog.
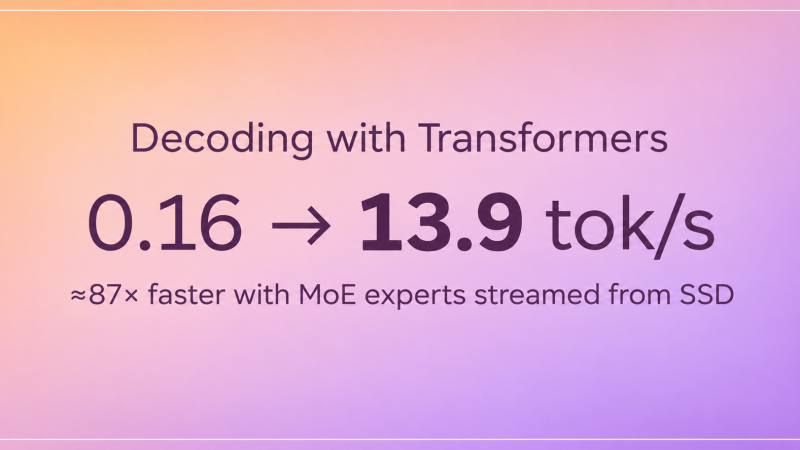
Hugging Face ha publicado una implementación experimental que permite ejecutar modelos MoE de 180.000 millones de parámetros en un Mac con 32 GB de memoria unificada.
NVIDIA RTX Spark compact desktops ya están a la venta con ASUS, Dell y MSI; los mini PC de Acer, GIGABYTE y HP, y el Surface RTX Spark Dev Box de Microsoft, llegan más adelante.
Amazon SageMaker HyperPod Inference ya ofrece.
Amazon SageMaker AI ha añadido el enrutamiento consciente de la caché KV (enrutamiento KV-aware), una nueva estrategia de enrutamiento para los endpoints en tiempo real.