Streaming De Expertos MoE Lleva Modelos De 180B A Un Mac De 32 GB
Hugging Face ha publicado una implementación experimental que permite ejecutar modelos MoE de 180.000 millones de parámetros en un Mac con 32 GB de memoria unificada. La pieza clave es un motor de streaming de expertos que alimenta el SSD como si fuera una extensión de la RAM, combinado con una caché acotada y kernels Metal escritos para macOS.
El trabajo, firmado por Tarek Ziadé y publicado el 18 de noviembre de 2026, parte de un problema práctico: los expertos de un modelo MoE concentran más del 90 % del peso total, así que un modelo grande cabe en una GPU modesta solo si los expertos «calientes» se quedan en VRAM y el resto se descarga. La idea del autor es que, cuando el modelo no cabe ni en RAM, hay que transmitir únicamente lo que el router selecciona token a token, a través de una caché acotada y lo bastante rápida para que el cuello de botella sea el SSD y no Python.
Los números que aporta la comparación son el centro del trabajo. Sobre un MacBook M5 con 32 GB de memoria unificada, Qwen3.8-Flash-Next (48 capas, 512 expertos por capa, 10 activos, 121 GB en FP8) se ejecuta con los expertos cuantizados a 3 bits en disco (49 GB), una caché de 12 GiB en el dispositivo y las capas densas en 8 bits, unos 5,4 GB con una pérdida de perplejidad del 0,2 % respecto a BF16. La conversión del modelo requiere alrededor de 5 horas y el consumo de memoria en reposo queda en unos 18 GB.
El resultado final sobre el M5 deja al implementation de Transformers a un 6 % de Strata, el motor de referencia usado como techo: 13,9 tok/s frente a 14,8 tok/s en decodificación de 200 tokens, 228 tok/s frente a 220 en prefill con prompt de 4K y 12,4 frente a 13,7 tok/s al decodificar tras un documento de 6K. El margen restante son turnos de ida y vuelta al host, alrededor de 10 ms por token.
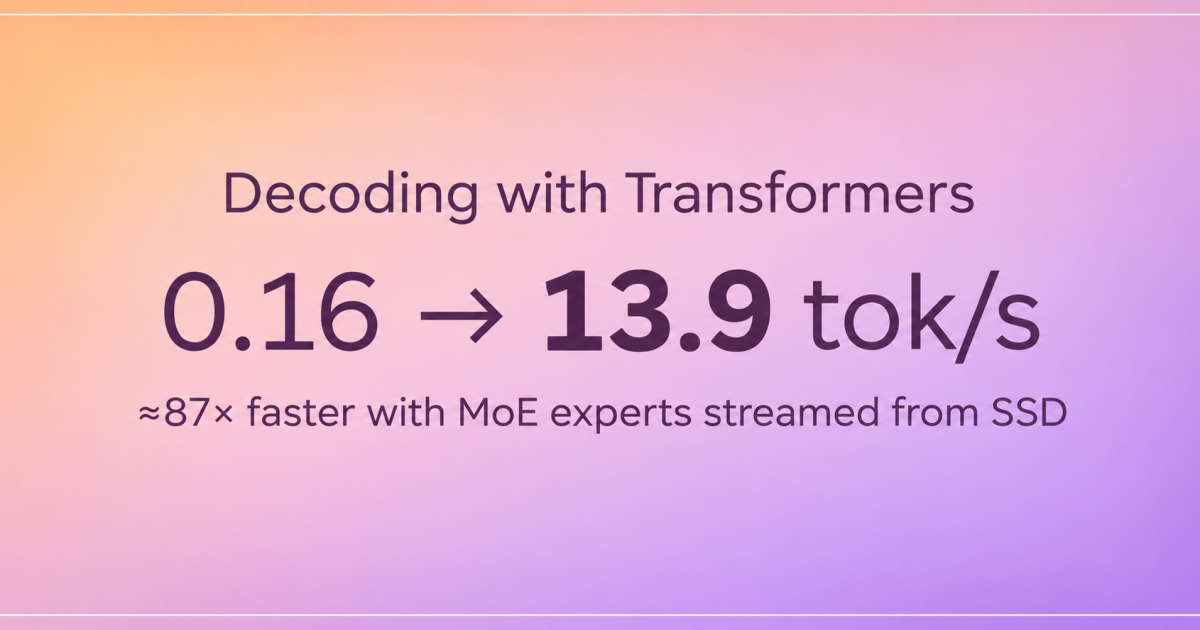
El dato más revelador para cualquiera que haya toreado inferencia viene del banco de pruebas con Qwen3.6-35B-A3B sobre una sola A10G de 24 GB. Strata en cuantización Q8_0 entrega 82-88 tok/s, llama.cpp se queda en 63-64, vLLM en BF16 con ajuste automático de memoria sube a 35-36, vLLM en FP8 con descarga de expertos a RAM fijada y solo expertos llega a 20,1 tok/s y Transformers con Accelerate apenas consigue 0,16 tok/s, prácticamente inutilizable. Offload en el otro motor de vLLM, el que copia grupos de capas por adelantado, baja de 1 tok/s.
La clave técnica está en convertir la caché en un pool de slots: un tensor de dispositivo preasignado compartido por todas las capas, más una tabla por capa que mapea identificador de experto a slot. Al remapear los identificadores del router, el pool se comporta como un banco de expertos normal y grouped_mm funciona sobre él tal cual, sin necesidad de un matmul de expertos a medida. El arranque con un modelo pequeño, OLMoE-1B-7B, pasó de 10,1 tok/s con un bucle Python a 34,6 tok/s con el pool de slots, frente a 38,1 tok/s de Transformers vanilla. La opción ya está en la pull request huggingface/transformers#50717 como experts_offload en from_pretrained, con lecturas en paralelo desde ocho hilos de E/S, una lectura contigua por experto y prefetch de las dos capas siguientes mediante los routers adelantados.
RESUMEN:
Hugging Face presenta una implementación experimental de streaming de expertos MoE dentro de Transformers, en la pull request #50717, que permite ejecutar Qwen3.8-Flash-Next de 180.000 millones de parámetros en un Mac de 32 GB de memoria unificada, con los expertos cuantizados a 3 bits en SSD y una caché de 12 GiB en el dispositivo. La técnica sustituye el offload clásico de Accelerate, que copia bancos de expertos completos en cada token y rendía 0,16 tok/s, por un pool de slots preasignado que el router remapea y que grouped_mm consume sin cambios, con ocho hilos de lectura y prefetch de las capas siguientes. Las mediciones finales en un MacBook M5 dan 13,9 tok/s en decodificación frente a los 14,8 tok/s de Strata, un 6 % de diferencia, con 228 tok/s en prefill y 12,4 tok/s tras un documento de 6K. En la comparación sobre una A10G de 24 GB con Qwen3.6-35B-A3B, Strata alcanza 82-88 tok/s, llama.cpp 63-64, vLLM en BF16 35-36, vLLM en FP8 con descarga de expertos 20,1 y Transformers con Accelerate 0,16. La implementación es solo Python y kernels Metal compilados en tiempo de ejecución con torch.mps.compile_shader, sin extensiones en C++, y el código y las pruebas están publicados en el Space tarekziade/moe-expert-streaming.
OPINIÓN:
Para un perfil de redes y telecomunicaciones lo interesante no es el titular del modelo de 180B, sino lo que hay debajo: la IA está dejando de depender del centro de datos y está entrando en el equipo del usuario final, con requisitos de red y disco muy distintos. Un Mac de 32 GB ejecutando un modelo MoE de 121 GB implica que el cuello de botella deja de ser la GPU y pasa a ser el PCIe y el SSD, y también la red, porque el caso de uso real es híbrido: la inferencia pesada en local y el modelo grande en la nube cuando la latencia no acompaña.
La lección más APPLICable es de arquitectura de servicios, no de IA: descargar pesos de forma indiscriminada por capa es contraproducente y castiga la latencia de forma brutal, del orden de 200 veces entre un motor bien diseñado y un offload mal planteado. Cualquier despliegue de inferencia en el borde, en una planta, en un centro de datos de piso en un dispositivo de campo, se va a encontrar con el mismo problema, y la respuesta parece ser la misma: caché acotada con política LRU, prefetch agresivo y cuantización para mover menos bytes por la línea.
También me quedo con la lección operativa: medir el caso real, no el de la ficha técnica. El trabajo compara seis configuraciones sobre el mismo modelo y expone que el motor con más funciones (vLLM, pensado para lotes grandes) pierde frente a uno simple en el escenario de un usuario y una GPU. Para redes, es un recordatorio de que la optimización depende del patrón de carga, y que un único número de throughput no dice nada.