NVIDIA ya vende desktops de IA local: 128 GB de memoria unificada, Ethernet de 10 G y modelos de 120.000 millones de parámetros en tu mesa
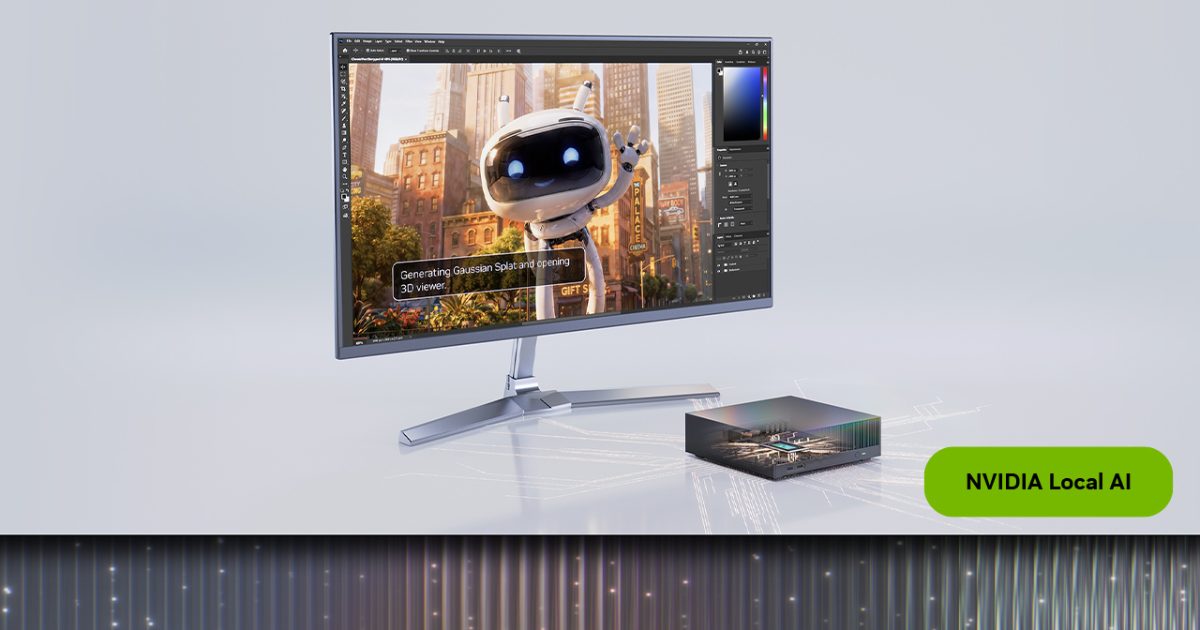
NVIDIA acaba de poner a la venta los primeros equipos compactos de su familia RTX Spark, en colaboración con ASUS, Dell y MSI. Son sobremesa de Windows dedicados a ejecutar IA en local: agentes que funcionan 24/7, generación de imagen y vídeo, y ajuste fino (fine-tuning) de modelos sin depender de la nube.
El hardware es una bestialidad para una caja tan pequeña: CPU NVIDIA Grace de 20 núcleos, GPU RTX Blackwell con 6.144 núcleos CUDA, hasta 128 GB de memoria unificada y hasta 1 petaflop de rendimiento en IA. La conectividad incluye Ethernet de 10 Gbps, pensada para mover con rapidez datasets, checkpoints y archivos pesados entre varios RTX Spark y el almacenamiento en red.
Qué significa en la práctica, según NVIDIA: poder ejecutar en local modelos de lenguaje de hasta 120.000 millones de parámetros, renderizar escenas 3D de más de 90 GB en tiempo real y editar vídeo 4:2:2 en tiempo real. Cada equipo es un nodo de inferencia que trabaja mientras el portátil del usuario viaja o hace otra cosa.
El ecosistema de software también se amplía. Hay aplicaciones nativas de Windows sobre Arm de Adobe, ray reconstruction DLSS en el visor de Blender 5.3 y flujos de generación local en ComfyUI. Para desarrollo, NVIDIA Switchyard enruta automáticamente las tareas del agente entre modelo local y modelo en la nube: lo cotidiano se queda en el equipo y el razonamiento complejo se delega al cloud, controlando así el gasto en tokens. Adobe añade aceleración TensorRT-RTX en Premiere (Enhance Speech, Object Mask, Auto Reframe) y Photoshop (Remove Tool), y sostiene que las entregas en H.264 se resuelven más de un 50 % antes.
Además, en Microsoft Ignite se ha anunciado que DGX Station for Windows (Grace Blackwell Ultra GB300) amplía su soporte a Windows Server 2028, y que Windows ML ya permite ejecutar cualquier modelo GGUF de Hugging Face mediante el backend llama.cpp, con un backend experimental DxCGC sobre DirectX 12.
Y ojo al resto de novedades que NVIDIA ha recopilado en este mismo post: llama.cpp v1.0.0, el modelo abierto Ripple-65B Preview de Ricursive Intelligence (entrenado en B300 y ejecutable en DGX Spark), el modelo de acción y vídeo Praxis-1 de 27.000 millones de parámetros de Runway (que corre en RTX 5090, RTX PRO 6000 y DGX) y NVIDIA TensorRT Edge-LLM para servir modelos en el borde.
- NVIDIA RTX Spark compact desktops ya están a la venta con ASUS, Dell y MSI; los mini PC de Acer, GIGABYTE y HP, y el Surface RTX Spark Dev Box de Microsoft, llegan más adelante.
- CPU Grace de 20 núcleos, GPU RTX Blackwell de 6.144 núcleos CUDA, hasta 128 GB de memoria unificada y 1 petaflop de IA, con Ethernet de 10 Gbps.
- Permiten ejecutar modelos de hasta 120.000 millones de parámetros en local, render 3D de 90 GB+ en tiempo real y edición de vídeo 4:2:2 en tiempo real.
- Switchyard enruta las tareas de los agentes entre el modelo local y el cloud para reducir el gasto por token; hay apps nativas de Adobe, DLSS en Blender 5.3 y ComfyUI nativo.
- Adobe acelera Premiere y Photoshop con TensorRT-RTX (más de 50 % más rápido en entregas H.264) y se anuncia Windows Server 2028 en DGX Station for Windows.
Esto me parece el movimiento con más impacto real de los últimos meses para un técnico de redes, más que cualquier lanzamiento de modelo. El discurso comercial de la IA sigue hablando de modelos gigantes y racks, pero la tendencia de fondo es la miniaturización: un equipo de sobremesa con 128 GB de memoria unificada y 10 Gbps es, a efectos de arquitectura, un mini nodo de inferencia con disco local. Para quien tiene que desplegar IA en una empresa sin pasar por un datacenter o sin enviar datos sensibles fuera, este tipo de equipo cambia la conversación: el agente vive en el rack del cliente, no en la nube.
El detalle de la memoria unificada es el que más me interesa, junto con el Ethernet de 10 Gbps. La memoria unificada evita el cuello de botella clásico de copiar pesos a VRAM, y una interfaz de 10 Gbps permite encadenar varios equipos para distribuir inferencia. Es, sin querer, la misma arquitectura de inferencia distribuida que se está montando en los clusters, pero a escala de sala de reuniones. Ahí es donde un técnico de redes puede aportar valor: gestionar ese bus, el almacenamiento en red y el ancho de banda para mover checkpoints.
El riesgo es el mismo de siempre: el marketing va por delante de la realidad. Un petaflop en formato FP4 no es un petaflop útil, y 120.000 millones de parámetros en 128 GB significa cuantización agresiva o que no todos los pesos caben a la vez. Me consta que la inferencia real de un modelo así en un equipo de sobremesa va a ser lenta para tareas largas. Aun así, la dirección es clara y, para cargas de inferencia continua, RAG local o agentes de escritorio, la latencia deja de ser un problema.
Me tranquiliza que NVIDIA insista en Switchyard: el modelo local resolviendo el día a día y el cloud para el razonamiento pesado es exactamente la estrategia que un departamento de TI puede defender. Es también la que mejor encaja con la sensibilidad de los datos y con el presupuesto, sin dejar de depender de nadie.