Salesforce enruta la inferencia entre regiones cuando falta capacidad
Amazon ha publicado en su blog de Machine Learning cómo el equipo de Agentforce Foundation de Salesforce monta el enrutamiento de inferencia entre regiones de SageMaker AI para resolver un problema que cualquier equipo de plataforma se encuentra tarde o temprano: la capacidad fragmentada.
Salesforce sirve modelos propios y open source desde más de 30 regiones y cientos de cuentas de AWS para productos como Agentforce y el Salesforce Trust Layer. Servir cada modelo por separado en cada región reparte la capacidad de una forma que convierte un déficit puntual de instancias en un problema de disponibilidad. Los picos de cada cliente no coinciden, pero provisionar para todos los picos simultáneos sale demasiado caro, y los equipos de negocio nuevos entran con poco aviso. El resultado es que hay regiones con instancias ociosas y otras que se quedan sin margen.
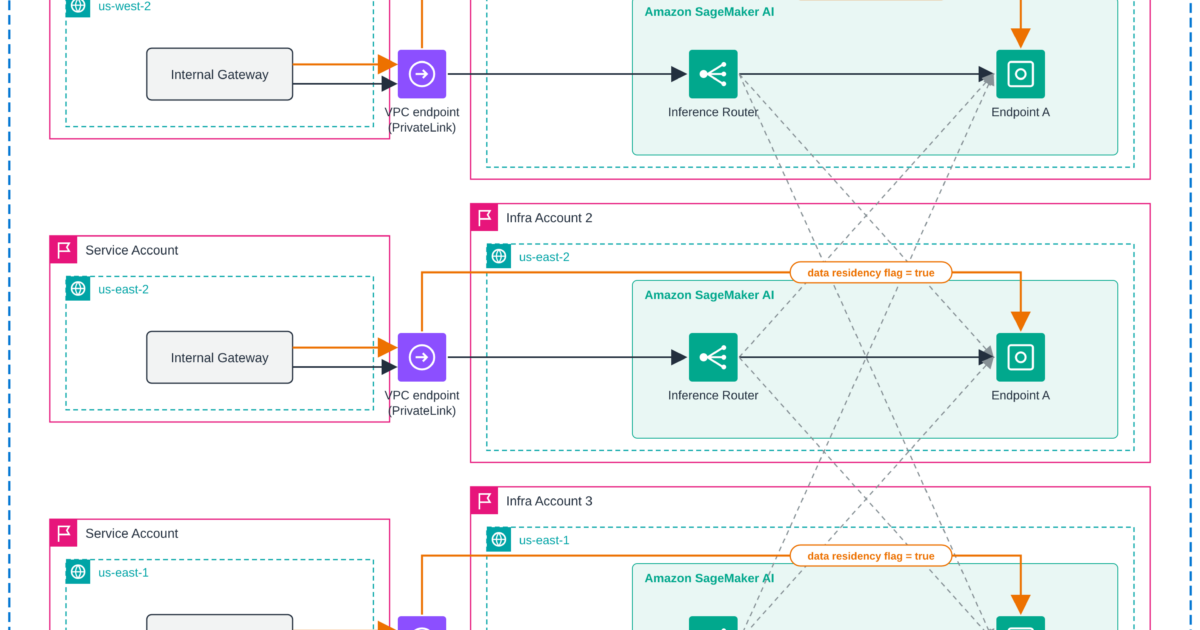
La solución publicada por AWS es un router de inferencia, un recurso regional de SageMaker AI que se crea en la cuenta del cliente. La aplicación deja de invocar el endpoint y llama al router, indicando un nombre de destino de enrutamiento junto al cuerpo de la petición. Cada destino de enrutamiento representa un modelo lógico y lista los endpoints y componentes de inferencia que pueden servirlo, identificados por su ARN, de modo que un destino puede estar en otra región o incluso en otra cuenta de AWS. La cuenta propietaria del endpoint concede el acceso con una política de recurso sobre el endpoint que limita la invocación a un router concreto mediante la condición sagemaker:SourceInferenceRouterArn.
La lógica de failover, que antes vivía en el Internal Gateway de Salesforce con comprobaciones de salud, reintentos y cambio de región escritos a mano, pasa ahora a la capa de enrutamiento gestionada. El router prefiere su propia región mientras el destino local sirva bien, y va deslocando peticiones hacia destinos sanos en función de los resultados recientes: fallos de plataforma, errores 5xx del contenedor del modelo, throttles y timeouts bajan la salud del destino, mientras que los errores de cliente por entrada inválida o una latencia alta del modelo no desplazan tráfico, porque se repetirían igual en cualquier región. Cuando un destino falla sin llegar a ejecutar el modelo, el router reintenta esa petición una vez en otro destino.
Los datos de la prueba de Salesforce son bastante concretos. El equipo inundó el endpoint local de us-west-2 hasta saturarlo y observó cómo la sonda seguinte registraba la latencia p50 subiendo de 0,2 segundos a entre 45 y 58 segundos, con el tráfico permaneciendo en la región local, que es el comportamiento previsto. Cuando las peticiones empezaron a superar el timeout de 60 segundos del contenedor del modelo y a devolver errores, el router movió tráfico: las primeras peticiones llegaron a us-east-2 unos dos minutos después del primer error y, en el minuto siguiente, cerca del 78 % del tráfico de la sonda se servía en la región remota. El 20-25 % restante se mantuvo en local para poder detectar la recuperación. Una vez movido el tráfico, la latencia p50 volvió a 0,2 segundos y el camino entre regiones añadió menos de 100 milisegundos en p50. Tras la recuperación del endpoint local, el tráfico volvió a us-west-2 de forma gradual durante unos 10 minutos, sin errores registrados ni durante el failover ni durante el failback.
Para un ingeniero de redes, lo relevante está en el diseño del plano de control y en las métricas. Salesforce registra en la misma línea de log estructurado el ARN del recurso que sirvió la petición y el motivo del enrutamiento, y los publica como etiquetas de APM: los cuatro valores posibles son local-preferred, failover, capacity-available y only-healthy. Como el ARN lleva región y cuenta, una sola línea permite saber si la llamada cruzó un límite. En CloudWatch se publican métricas OpenTelemetry, entre ellas aws.sagemaker.inference_router.invocations, con el atributo error.type que separa invocation_4xx, invocation_5xx e invocation_model_error, aws.sagemaker.inference_router.destination.duration, aws.sagemaker.inference_router.overhead.duration y aws.sagemaker.inference_router.destination.status, que informa del estado healthy, overloaded o degraded de cada destino.
Hay dos detalles que conviene no pasar por alto. El primero es laresidency: una petición con la marca de residencia de datos se ancla a su destino de enrutamiento local, cuyo único destino es el endpoint de su región, de manera que nunca puede hacer failover fuera del límite. El segundo es el tope de tráfico entre regiones, configurable por el endpoint receptor con CrossRegionTrafficConfig como tasa de peticiones por instancia y como porcentaje máximo de su capacidad que el tráfico remoto puede usar; el tráfico local nunca cuenta contra ese tope y, al alcanzarlo, el endpoint deja de aceptar peticiones de otras regiones. El router no despliega modelos, no copia artefactos y no crea capacidad: si todos los destinos elegibles están ocupados, la aplicación recibe los errores del propio destino. Por eso AWS recomienda mantener el mismo modelo, imagen de contenedor y artefactos en todas las regiones registradas, porque un destino con otra versión del modelo devolverá respuestas distintas para la misma petición.
Amazon publica cómo Salesforce despliega el enrutamiento de inferencia entre regiones de SageMaker AI para convertir la falta de capacidad en un problema de disponibilidad gestionado. El router es un recurso regional de SageMaker AI al que la aplicación llama en lugar de invocar el endpoint, y cada destino de enrutamiento lista endpoints de otra región o de otra cuenta mediante su ARN y una política de recurso con la condición sagemaker:SourceInferenceRouterArn. En la prueba de failover, el tráfico pasó a us-east-2 con cerca del 78 % de las peticiones unos minutos después de los primeros errores y volvió de forma gradual en unos 10 minutos, con menos de 100 milisegundos añadidos en p50. Cada respuesta incluye el ARN del destino y el motivo del enrutamiento, y CloudWatch publica métricas OpenTelemetry por destino con su estado de salud.
Lo interesante del caso es que, detrás de una noticia de IA, hay un problema de red puro: reparto de carga entre centros de datos con 제약 de residencia de datos y riesgo de fallos en cascada. Durante años esto se resolvía a mano en el gateway de la aplicación, con comprobaciones de salud, reintentos y lógica de cambio de región, y ese código casaba mal cuando el pico de un cliente se solapaba con otro. Que la señalización de capacidad viva en la capa de enrutamiento y no en cada aplicación es un cambio de fondo.
Lo que más me convence es la honestidad de las métricas: que el enrutamiento no se mueva solo por latencia alta, sino por errores reales, y que el sistema deje deliberadamente un 20-25 % del tráfico en local para poder detectar la recuperación evita el vaivén entre regiones. En redes, ese tipo de histéresis no es un detalle: es lo que evita que un incidente se propague al siguiente centro de datos.
Los puntos de fricción son los de siempre: el router no crea capacidad, así que hay que provisionar el margen en cada región y mantener el mismo modelo y artefactos en todas, porque una versión divergente devuelve respuestas distintas para la misma petición y eso es un problema de trazabilidad difícil de diagnosticar. El tope de tráfico entre regiones es una buena idea, pero obliga a dimensionar cada destino pensando en lo que puede recibir de fuera, no solo en su carga local. Y la condición sobre la política del endpoint es el tipo de detalle que, si se olvida, deja al router con un fallo silencioso: por eso el DescribeInferenceRouter con su estado Routable, Unroutable o Unknown debería entrar en la checklist de despliegue, igual que una prueba de enrutamiento BGP antes de confiar el tráfico.