Una IA diseña desde cero una CPU 4,59 veces más eficiente
Architect Labs presenta Frostbite, una CPU de propósito general con ISA propio, descubierta, diseñada y verificada de extremo a extremo por sus sistemas de IA, sin arquitectura previa.
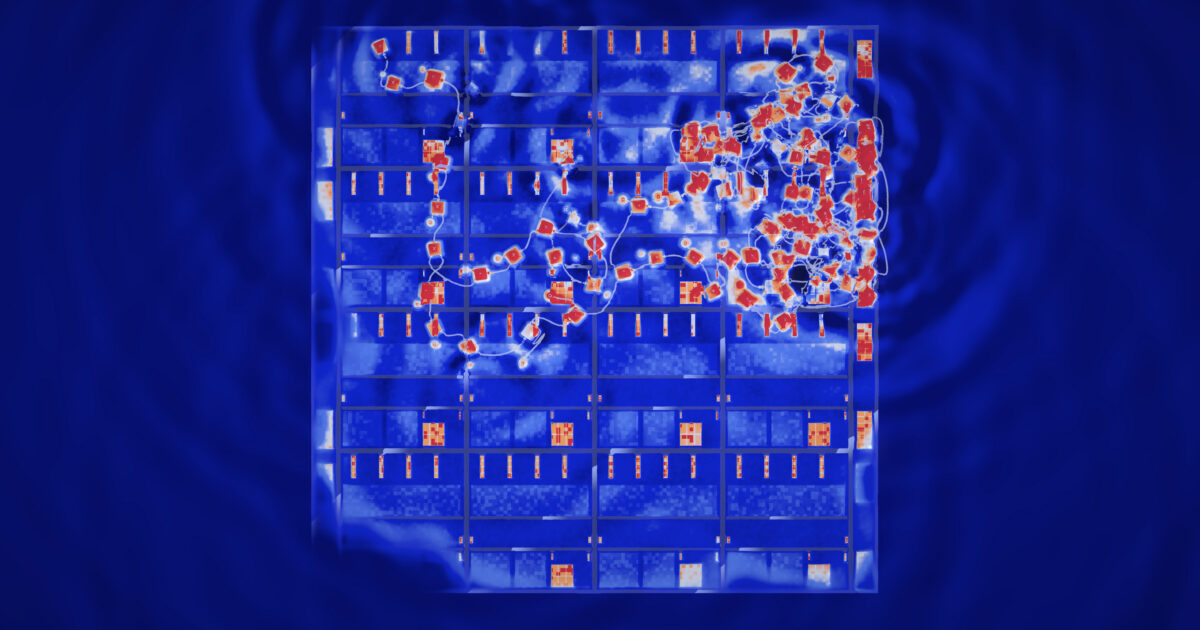
Architect Labs deja que sus agentes diseñen una CPU completa
Architect Labs, la compañía que hace unos meses presentó Redwood, un acelerador de inferencia implementado y verificado por sus sistemas de IA, ha dado un paso bastante más ambicioso: Frostbite, una CPU de propósito general con un conjunto de instrucciones nuevo, construida desde cero y sin arquitectura previa, en la que sus agentes recorrieron toda la cadena, desde el compilador hasta el GDS final de silicio. El resultado que publican es una cifra concreta y comprobable: 4,59 veces más rendimiento por vatio que un núcleo superescalar comercial (dos vías, en orden), medido sobre 25 cargas de trabajo, de las cuales 15 quedaron apartadas hasta la evaluación final para que el diseño no pudiera ajustarse a lo que estaba viendo.
La premisa de la que parten es conocida por cualquiera que haya seguido la evolución del hardware: el rendimiento por núcleo está prácticamente estancado desde principios de los años 2000, y la respuesta de la industria ha sido apilar núcleos, con Xeon de Intel, Zen de AMD o Vera de NVIDIA como ejemplos, a costa de sostener la ilusión de una memoria compartida coherente. Esa ilusión se paga con jerarquías de caché profundas, protocolos de coherencia y máquinas fuera de orden, que consumen área y vatios y escalan mal. Frostbite ataca justo ese punto.
La base arquitectónica son las redes de interacción (interaction nets). En lugar de un estado mutable compartido, un programa se representa como un grafo de nodos y la computación consiste en reescribir pares de nodos conectados por sus puertos. Cada reescritura toca una parte pequeña y local del grafo, y como cada nodo tiene un único puerto principal, dos pares activos nunca se solapan: se pueden ejecutar en cualquier orden, o todos a la vez, y el resultado es idéntico. Además, cada valor se usa exactamente una vez, así que no hay estado compartido que el hardware tenga que proteger.
Eso tiene dos consecuencias grandes. La primera es paralelismo casi gratuito: no hay hilos, bloqueos ni condiciones de carrera que gestionar, y el hardware no necesita maquinaria fuera de orden para redescubrir dependencias que el programa ya exponía. La segunda es que, al ser cada valor de un solo propietario y cada paso local, los datos pueden vivir en memorias pequeñas junto a donde se usan, lo que elimina buena parte del área y la potencia que un chip convencional dedica a cachés y a mantenerlas coherentes. Architect Labs ilustra el efecto con un ejemplo pequeño: un problema de cinco reinas en un tablero de 5×5, donde la versión secuencial prueba candidatos de uno en uno mientras la red expone, como media, unas doce interacciones listas para ejecutarse en cada paso. Nada del programa se reescribió para lograr ese paralelismo: simplemente nunca se descartaron las dependencias.
El proceso que describen es lo más interesante para quien se dedica a ingeniería de sistemas. Empezaron definiendo el conjunto de cargas de trabajo, agrupadas en categorías: muchas piezas independientes a la vez, rondas de trabajo en paralelo, cadenas secuenciales largas, ramas dependientes de datos y recursión. Bajo cada categoría crearon un conjunto de búsqueda y un conjunto de evaluación reservado, para comprobar que el diseño generalizaba a programas que nunca había visto. Los kernels de FFT, radix sort y descomposición LU siguen la implementación del benchmark SPLASH-2, aunque 64 veces más pequeños, porque a tamaños normales no sirven para trabajo exploratorio. Después añadieron cinco cargas prácticas: un filtro de Kalman, PCA, análisis por elementos finitos, una resolución LU y descompresión con LZ4.
Los agentes sintetizaron papers y benchmarks, construyeron modelos en Python para comparar ideas de alto nivel y acabaron produciendo un PDF de 141 páginas con el modelo de programación, el runtime y los bloques principales del chip. Ese documento se borró después de la primera generación de RTL, porque muchos de sus números y estimaciones estaban lejos de lo que era físicamente posible. La lección que sacan es explícita: el lenguaje natural no puede capturar todos los detalles que necesita una implementación ni garantizar que se detecte cada alucinación de un agente mientras se diseña y verifica un ASIC.
De ahí nace ASL, un lenguaje de especificación propio, comprobable por máquina, con el que escribieron el modelo del sistema, llamado Arcmodel. Según sus mediciones, sus estimaciones de potencia y rendimiento están a un 1 o 5 por ciento de la realidad, corre unas 200 veces más rápido que la simulación de RTL y se puede verificar formalmente mediante contratos. ASL traduce de forma nativa a Lean, que es lo que usan para todas las pruebas de teoremas que comprueban las salidas de la IA sobre RTL, UVM, C, SVA y demás artefactos. Al final del proyecto, la especificación ASL de Frostbite descendía a más de 800.000 líneas de Lean.
El punto que resuelve el problema de las alucinaciones es haber establecido un único origen de verdad demostrable. Arcmodel no conoce la física del chip, así que en las primeras iteraciones sus estimaciones de potencia y rendimiento se desviaban del RTL real, en el peor caso casi un 250 por ciento. El sistema corrige esa deriva de forma autónoma: localiza los puntos calientes de potencia en el RTL, los rastrea hasta contadores concretos de la especificación formal (lecturas y escrituras de SRAM, conteo de operaciones, flits enviados y recibidos, devoluciones de crédito, fallos de trama) y ajusta una función escalar en Python que predice la potencia. Repite el bucle hasta que modelo y RTL coinciden con un margen del 5 por ciento. Las simulaciones completas del chip quedan así 660 veces más rápidas que el RTL, lo que permite optimizaciones cruzadas entre capas en cuestión de horas, algo prácticamente imposible en un flujo ASIC tradicional.
En la fase de exploración de la arquitectura, enjambres de agentes propusieron revisiones en árboles de trabajo paralelos y cada cambio se validó contra los contratos, se modeló en Arcmodel, se implementó en RTL y se midió en potencia antes de decidir si se quedaba o se descartaba. A lo largo de cuatro búsquedas y una ronda final de ablaciones probaron 58 ideas y conservaron 37, desde compuertas de reloj sobre un tile en marcha hasta tablas L3 más pequeñas y un único expander compartido. Los programas se escriben en Vine, un lenguaje con sintaxis parecida a Rust, que compila a Ivy, la representación intermedia que codifica la red de interacción con tres primitivas: nodos de datos, de cómputo y de control.
- Architect Labs presenta Frostbite, una CPU de propósito general con ISA propio, descubierta, diseñada y verificada de extremo a extremo por sus sistemas de IA, sin arquitectura previa.
- Alcanza 4,59 veces más rendimiento por vatio que un núcleo superescalar comercial de dos vías en orden, sobre 25 cargas de trabajo, con 15 reservadas hasta la evaluación final.
- Se basa en redes de interacción: computación local, dependencias explícitas y un único propietario por valor, lo que elimina estado mutable compartido y buena parte del coste de cachés y coherencia.
- Usa ASL, un lenguaje formal propio que traduce a Lean, como único origen de verdad entre modelo del sistema, RTL y verificación, con más de 800.000 líneas de Lean al final.
- El enjambre probó 58 ideas arquitectónicas y conservó 37, con un bucle autónomo que alinea potencia y rendimiento entre Arcmodel y RTL con un margen del 5 por ciento.
Desde el punto de vista de un técnico de redes y telecomunicaciones, lo más relevante no es la CPU en sí, sino la afirmación final del artículo: que cualquier clase de chip, desde CPUs de centro de datos hasta aceleradores de IA, e incluso switches de red y NICs, va a pasar por cambios arquitectónicos similares. Si eso se cumple, el impacto en los equipos que hoy sostienen la infraestructura de operadores y proveedores es directo. Buena parte del consumo de un router moderno está en los ASIC de conmutación y en las memorias de tabla, no en los núcleos de control, y los razonamientos sobre localidad, propiedad única de los valores y ausencia de coherencia de memoria aplican de lleno a las estructuras de tabla y a los pipelines de reenvío.
Hay que leerlo con cuidado. Las cifras de 4,59 veces son pre-silicio, y la propia compañía reconoce que sus números de potencia son estimaciones del modelo, no medidas de producción: la correlación con cifras reales requiere varios ciclos de tapeout. El diseño tampoco es una CPU lista para servidores, sino un núcleo generalista evaluado sobre kernels pequeños y cargas escogidas. Aun así, el valor del ejercicio está en el método: especificación formal comprobable, modelo rápido alineado con el RTL y enjambres de agentes que no pueden «hacer trampa» porque todo se contrasta contra contratos demostrables. Ese patrón es mucho más portable que Frostbite y probablemente acabe copiándose en el diseño de equipos de red, donde la verificación formal ya es obligatoria y el coste del ciclo de diseño es brutal.
Referencia y documentación original: Architect Labs.
También te puede interesar
Lambda lleva la óptica empaquetada al centro de la red de IA
Lambda usa switches con óptica empaquetada NVIDIA Photonics (CPO) para conectar racks GB300 NVL72 que suman más de 10.000 GPU en una fábrica de IA a escala.
El Apple Watch que escucha siempre y borra el audio al instante
Siri Recap del Apple Watch Ultra 4 resume conversaciones ambientales sin transcripción visible y borra el audio original tras procesarlo.
Crisis de memoria: Intel se hunde 28,6% y sus accionistas demandan
Accionistas demandan a Intel, a Lip-Bu Tan y a David Zinsner por supuestas declaraciones enganosas entre el 23 de julio y el 29 de octubre.