Lambda lleva la óptica empaquetada al centro de la red de IA
Lambda usa switches con óptica empaquetada NVIDIA Photonics (CPO) para conectar racks GB300 NVL72 que suman más de 10.000 GPU en una fábrica de IA a escala.
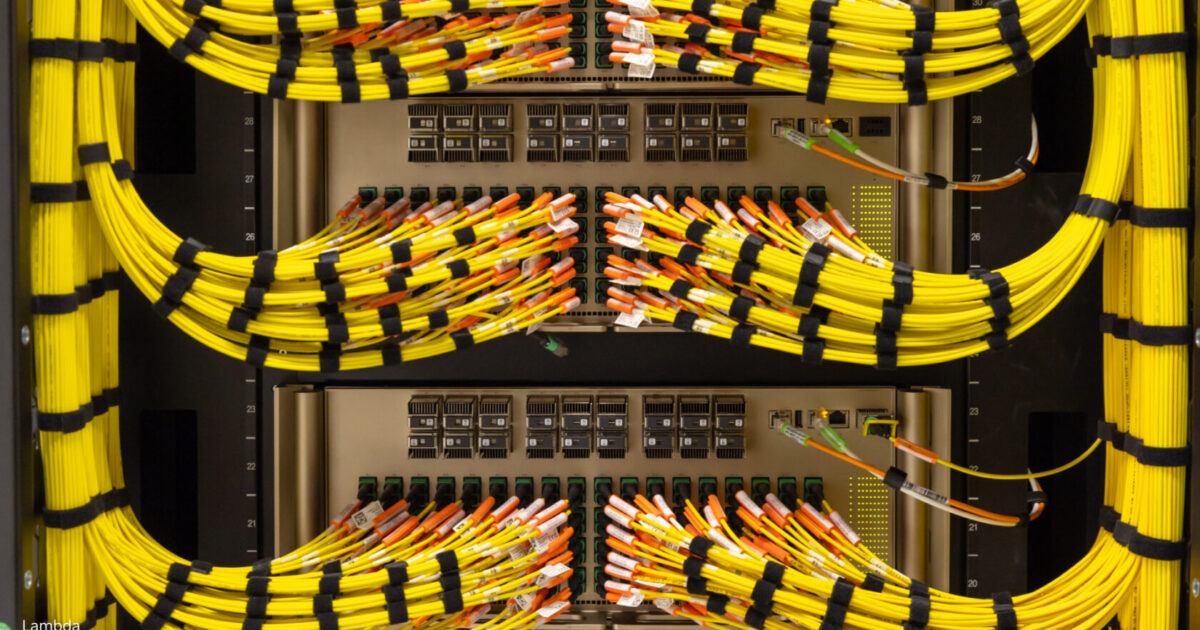
Lambda lleva la óptica empaquetada al centro de la red de IA
Lambda, un proveedor de cómputo basado en GPU, ha puesto en producción una red de clústeres de IA construida sobre switches con óptica empaquetada NVIDIA Photonics, la tecnología CPO. El despliegue conecta racks NVIDIA GB300 NVL72 que suman más de 10.000 GPU y forma parte de lo que la empresa denomina una fábrica de IA a escala. El motivo declarado no es batir una marca, sino bajar el consumo y evitar que la red se convierta en el punto débil del sistema.
El punto de partida es un problema conocido por cualquiera que haya operado un clúster grande. En un trabajo de entrenamiento, un solo enlace interrumpido puede dejar paradas miles de GPU mientras el resto espera. En inferencia agéntica el efecto es distinto pero igual de caro: un agente que razona, llama a herramientas y comprueba su resultado genera tokens en cada paso, así que una perturbación de red se convierte en latencia en cascada sobre muchos agentes a la vez. Cada vatio gastado en la red es un vatio que no llega a la computación.
Según Dave Ward, presidente de servicios cloud de Lambda, la red tiene que ir al ritmo que imponen los clústeres de IA cada vez más grandes, y llevar la óptica empaquetada a un despliegue de esa escala es un paso hacia la infraestructura que necesitará la próxima generación de IA. En sus pruebas, los switches redujeron la latencia de red alrededor de un 4 % a escala de rack y hasta un 10 % a escala de pod, manteniendo el mismo caudal que se obtiene con la óptica enchufable convencional.
Las cifras de eficiencia y fiabilidad que aporta NVIDIA respecto a la óptica enchufable tradicional son el argumento central del cambio. La compañía afirma que la empaquetación de la conversión eléctrico-óptica junto al chip del switch entrega hasta cinco veces mejor eficiencia energética y hasta quince veces más fiabilidad, y que usa cuatro veces menos láseres, es decir, menos componentes que pueden fallar. La explicación es física y bastante directa: acortar el camino eléctrico de pulgadas a milímetros reduce la pérdida de señal, permite eliminar los chips de retemporización y ahorra tanto consumo como piezas en la ruta de la señal.
El despliegue de Lambda usa switches con 144 puertos a 800 Gb/s cada uno, con refrigeración líquida para evacuar el calor tanto del chip del switch como de los motores ópticos. La empresa informa de una temperatura mediana de la óptica de 36 °C, frente a los 51 °C de la óptica enchufable convencional, y sus pruebas muestran una integridad de señal más estable. Menos temperatura y menos calor se traduce, en la práctica, en menos refrigeración y más vatios disponibles para el cálculo.
Hay un detalle de mantenimiento que importa especialmente a quien opera infraestructura: cada switch incorpora 18 fuentes de luz externas y reemplazables, que alimentan los motores ópticos. La diferencia con la óptica enchufable tradicional es que, cuando falla un láser, el técnico sustituye el módulo de fuente de luz en el propio rack, no el transceptor completo. Para una planta con más de 10.000 GPU, la diferencia entre una sustitución de cinco minutos y una ventana de mantenimiento con piezas de repuesto es la diferencia entre perder una GPU o perder un clúster.
La fotografía del sector apunta en la misma dirección. El suministro de componentes ópticos es hoy uno de los cuellos de botella citados por la dirección de operaciones de NVIDIA, que ha tenido que invertir en fabricantes como Coherent y Lumentum para que tengan la escala y el capital necesarios, porque hasta ahora tenían la tecnología y la voluntad pero no las fábricas que el volumen de la IA exige. La óptica empaquetada, al mover la integración al propio paquete del switch, está obligando a crear cadenas de suministro nuevas con fabricantes que antes no trabajaban en el mundo de la óptica. Lo mismo está ocurriendo con los conectores: el cartucho de cable de Amphenol, con 1.500 patas y una calidad inferior a una pieza defectuosa por millón, requirió más de cien líneas automatizadas en Vietnam para producirlo al ritmo que NVIDIA necesita.
El punto que conecta todo esto con la operación diaria es que la red ha dejado de ser el elemento que se dimensiona en segundo plano y ha pasado a ser el que decide el rendimiento total de la fábrica de IA. Si el switch es el punto donde se decide el caudal, el consumo y la disponibilidad, entonces el diseño óptico deja de ser una decisión de hoja de ruta del fabricante de hardware y pasa a ser una decisión de arquitectura de red, con sus propios ciclos de vida de componentes, sus procedimientos de sustitución en caliente y sus números de disponibilidad media entre interrupciones.
La dirección de la tendencia es clara: la energía está siendo el recurso escaso que limita los centros de datos de IA, y cada vatio que se ahorra en la red es un vatio que vuelve a la computación. La óptica empaquetada es, de momento, la palanca más directa que existe para ese problema concreto, y que un proveedor de infraestructura de tamaño medio ya la haya puesto en producción a escala de 10.000 GPU dice bastante sobre en qué punto está la madurez de la tecnología.
- Lambda usa switches con óptica empaquetada NVIDIA Photonics (CPO) para conectar racks GB300 NVL72 que suman más de 10.000 GPU en una fábrica de IA a escala.
- En sus pruebas, la latencia de red baja alrededor de un 4 % a escala de rack y hasta un 10 % a escala de pod, manteniendo el mismo caudal que la óptica enchufable convencional.
- NVIDIA atribuye a la empaquetación hasta 5 veces mejor eficiencia energética y hasta 15 veces más fiabilidad que la óptica tradicional, con 4 veces menos láseres y sin chips de retemporización.
- Los switches tienen 144 puertos a 800 Gb/s, refrigeración líquida y una temperatura mediana de óptica de 36 °C frente a los 51 °C de la óptica enchufable.
- Cada switch incluye 18 fuentes de luz externas y reemplazables en campo: si falla un láser se cambia el módulo, no el transceptor completo.
Para un ingeniero de redes, esta noticia importa por una razón concreta: la idea de que «pero la red no es el problema» se ha acabado en los clústeres de IA. Con miles de GPU en una sola fabricación, un enlace que se cae no molesta a un usuario, levanta un evento de entrenamiento completo. Cuando el producto de NVIDIA sostiene que la óptica empaquetada multiplica por cinco la eficiencia energética de la interconexión, la lectura para un operador es que el presupuesto de vatios del centro de datos se está desplazando del rack hacia el switch, y eso cambia el dimensionado de la refrigeración y de la alimentación.
Lo que más me convence del enfoque es el de la reparabilidad. La historia de la posibleptic ha sido siempre la misma: los transceptores enchufables se rompían y había que sustituirlos; con fuentes de luz reemplazables en caliente, el modo de fallo se convierte en una operación rutinaria de rack en lugar de una incidencia. Es una mejora operacional modesta en apariencia y enorme en un entorno donde una ventana de mantenimiento de un nodo de 10.000 GPU cuesta mucho dinero. La contrapartida es que aparece una nueva cadena de suministro, con proveedores de óptica que antes no estaban en el mapa del centro de datos, y eso implica un riesgo de aprovisionamiento nuevo que conviene vigilar.
La otra lectura es la del consumo. Cada vatio que se ahorra en la red es un vatio que vuelve al cálculo, y con las fábricas de IA limitadas por la potencia disponible y no por el número de chips, ese margen se traduce directamente en más sesiones de inferencia servidas. Lo adoptamos con reservas, no por la tecnología en sí, sino porque un proveedor que opera a escala de 10.000 GPU es la prueba de que la operación diaria funciona, y eso es exactamente lo que las primeras implantaciones de CPO siempre habían dejado por demostrar.
Referencia y documentación original: NVIDIA Blog.
También te puede interesar
El Apple Watch que escucha siempre y borra el audio al instante
Siri Recap del Apple Watch Ultra 4 resume conversaciones ambientales sin transcripción visible y borra el audio original tras procesarlo.
Crisis de memoria: Intel se hunde 28,6% y sus accionistas demandan
Accionistas demandan a Intel, a Lip-Bu Tan y a David Zinsner por supuestas declaraciones enganosas entre el 23 de julio y el 29 de octubre.
Una IA diseña desde cero una CPU 4,59 veces más eficiente
Architect Labs presenta Frostbite, una CPU de propósito general con ISA propio, descubierta, diseñada y verificada de extremo a extremo por sus sistemas de IA, sin arquitectura previa.