La estimación de FLOPs falla, y un modelo de regresión la arregla
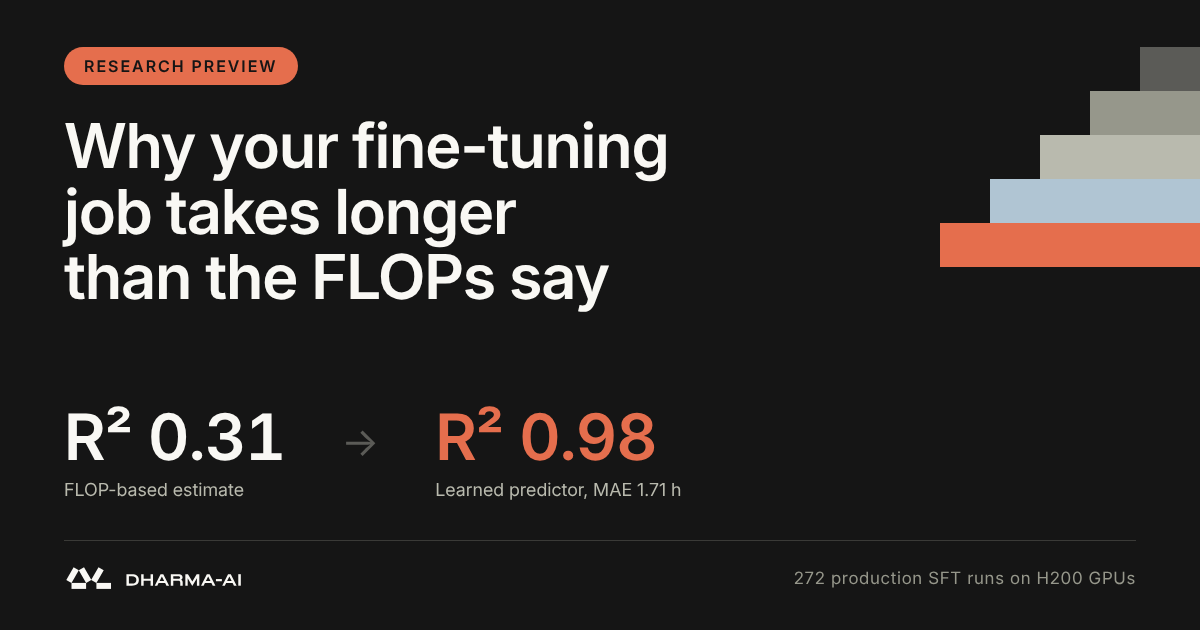
Calcular cuánto va a tardar un job de fine-tuning a partir de los FLOPs de la ficha técnica de la GPU es la práctica habitual en cualquier clúster compartido. El equipo Dharma-AI, publicado en Hugging Face, ha medido cuánto se equivoca ese método con 272 ejecuciones reales de ajuste fino supervisado sobre un pool de GPU NVIDIA H200, unas 7.382 GPU-horas en total, y propone una alternativa: un regresor CatBoost que estima la duración con un error absoluto medio de 1,71 horas.
La estimación teórica, T = (6 · P · D) / (N_GPU · FLOPS_peak · MFU), alcanza un R² de 0,31 con un MAE de 12,41 horas, y el resultado empeora al subir la eficiencia asumida: con MFU del 60 % el R² cae hasta 0,01. Ningún valor de MFU entre 0,25 y 0,65 salva la base analítica. El punto es que esa fórmula solo describe el bucle de optimización: ignora la preparación del entorno, la descarga y carga del modelo, la tokenización, las evaluaciones periódicas, las subidas de checkpoints y el guardado final del modelo en almacenamiento de objetos. En un clúster multiinquilino, todo eso compite por red y E/S con el resto de trabajos.
El predictor propuesto solo usa información disponible antes de lanzar el trabajo: hiperparámetros, tamaños de dataset, identificadores de modelo y asignación de GPU. La regresión lineal se queda en un MAE de 7,52 horas y Ridge en 7,23, pero el salto lo dan los modelos de gradient boosting: XGBoost llega a 1,95 horas de MAE y CatBoost a 1,71, con un R² de 0,98 en validación cruzada de 5 pliegues. La mediana del error absoluto baja a 0,51 horas, el 80 % de las predicciones cae dentro de 2,20 horas y el 90 % dentro de 4,31 horas.
Las variables que más pesan no son las obvias. La primera en importancia es el volumen total de muestras procesadas en la evaluación a lo largo de la vida del trabajo, seguida del número de parámetros entrenables, el porcentaje de datos de evaluación por lote, el total de parámetros y la carga por GPU. Es decir, la duración real la marcan las decisiones de configuración que se toman por costumbre al escribir el fichero de configuración: cada evaluación y cada checkpoint persistido cuesta tiempo real.
Los datos vienen de un entorno corporativo real: modelos de hasta 15.000 millones de parámetros, LoRA y fine-tuning completo, trabajos de 1 a 4 GPU sobre un pool de entre 8 y 32 H200 en 1 a 4 nodos, con duraciones de 1,6 a 172,4 horas (media de 23,43 y mediana de 15,29). El equipo también probó Calculon, modelo analítico de rendimiento para entrenamiento de LLM publicado en SC 2023, extendido para cubrir LoRA, grouped-query attention, atención fusionada, bfloat16 y SwiGLU: sus estimaciones siguen correspondiendo a una mediana del solo 11 % del tiempo real observado.
- 272 jobs reales de fine-tuning sobre GPU NVIDIA H200 (7.382 GPU-horas) analizados para medir el error de la estimación clásica por FLOPs.
- La base analítica con MFU al 30 % se queda en R² de 0,31 y 12,41 horas de error medio; ningún ajuste de MFU la salva.
- Un regresor CatBoost con 24 variables de configuración previa alcanza R² de 0,98 y 1,71 horas de error medio, con mediana de 0,51 horas.
- Las variables dominantes son la carga de evaluación y el número de checkpoints, no solo el modelo ni los datos.
- Solo se ha medido con H200 y SFT: el método es transferible, pero las cifras requieren recalibración para otro hardware.
Desde el punto de vista de un técnico de redes, esto encaja con lo que ya sabemos: los cuellos de botella rara vez están donde los modelos los predicen. El cálculo por FLOPs es la foto del servidor y no del tráfico. Lo que se ha medido aquí es, en esencia, un problema de concurrencia de red y almacenamiento: evaluación, checkpoints y cargas de modelo son operaciones de E/S que no escalan con el número de GPU y que en un clúster compartido pelean por ancho de banda. Cuando alguien mete cuatro GPU H200 a un job, el cuello de botella puede ser el enlace del nodo, no la capacidad de cómputo.
La implicación práctica es que merece la pena instrumentar el planificador para aprender de los logs de ejecución en lugar de fiarse de la fórmula, y que conviene medir por separado la latencia de subida de checkpoints y la de E/S de red, porque son variables que un equipo de redes puede optimizar. Si el predictor dice que un job tarda 30 horas y la estimación dice 8, la diferencia no está en la GPU: está en cuánto tráfico de checkpointing hay y en cuántas evaluaciones has configurado por costumbre.