OpenAI reescribe el RTL de AMD y mejora hasta un 14 % su GPU insignia
OpenAI publica como sus modelos reescriben RTL en SystemVerilog y validan cada cambio con herramientas de Synopsys. Lo que importa aquí no es el 14 %, sino dónde está la responsabilidad.
La IA ya diseña chips que llegan a fabricación
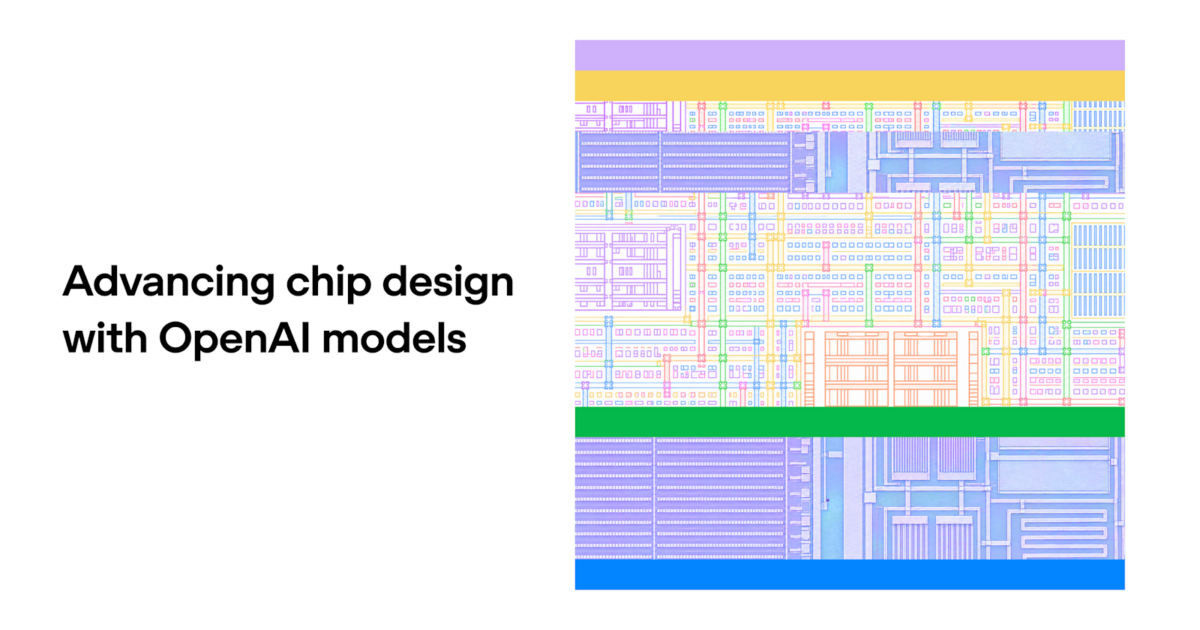
Hay una frontera de la IA donde el salto de productividad se mide en micrómetros y miliwatios, no en tokens por segundo: el diseño de circuítos integrados. OpenAI acaba de publicar los detalles de cómo sus modelos reescriben directamente el RTL en SystemVerilog de chips de producción, y los resultados que ha obtenido junto a AMD son difíciles de ignorar.
Un rediseño de un multiplicador en coma flotante propuesto por el modelo ocupa alrededor de un 15 % menos de área de celdas estándar en la síntesis y reduce la latencia de dos ciclos de reloj a uno. Otro sumador, rediseñado por el mismo camino, ahorra cerca de un 15 % de área conservando sus dos ciclos. En el conjunto del diseño de Jalapeño, el chip de inferencia propio de OpenAI, el equipo estima que los cambios propuestos por los modelos redujeron el área de celdas estándar un 13 % en la unidad vectorial y un 10 % en la unidad de matriz. Y lo más importante: esas optimizaciones fueron validadas en silicio durante el proceso de bring-up del chip, no solo en simulador.
El punto que cambia las reglas no es el porcentaje. Es la precisión con la que el modelo razona sobre RTL al nivel de un microarquitecto experto, capaz de reescribir circuitos que ejecutan cálculos, controlan operaciones o mueven datos, y de comprobar con las herramientas de Synopsys que cada reescritura conserva el comportamiento del bloque original. Eso es un bucle cerrado: proponer, verificar con las herramientas EDA que los ingenieros ya usan y evaluar el compromiso entre potencia, rendimiento y área. El modelo no suplanta al ingeniero; se mueve dentro de su cadena de herramientas.
La colaboración con AMD es la parte que más interesa a quien trabaja con hardware de verdad. OpenAI afirma haber visto mejoras de hasta un 14 % en PPA frente a líneas base ya fuertemente optimizadas en la IP de GPU insignia de AMD, mediante la reescritura del código que describe los circuítos del chip. El texto lo resume sin rodeos: se trata de aproximadamente un año de progreso conseguido en menos de cinco meses. AMD ya ha incorporado algunos de esos cambios en un diseño reciente enviado a fabricación y ha añadido otros más a sus ficheros de producción para versiones futuras. Además, AMD verificó ganancias de un solo dígito porcentual en PPA en bloques clave de su próxima CPU insignia usando diseños escritos por el modelo.
Para quien mantiene clústeres de GPU, esto significa que la ventaja competitiva puede empezar a venir no solo de qué chip compras, sino de cuánto diseño propietario puedes meter en tu silicio. Una mejora del 14 % en PPA se traduce, en la práctica, en más FLOPS por vatio y por dólar, es decir, más tokens por kilovatio en un rack. Pero también significa una dependencia nueva: el silicio pasa a depender del comportamiento de un modelo, y cualquier deriva o error de ese modelo se convierte en un problema de hardware.
OpenAI también midió la progresión entre generaciones con dos núcleos RISC-V de código abierto: PicoRV32, un núcleo compacto para FPGA, e Ibex, el procesador embebido del chip de seguridad OpenTitan. La tarea era sencilla sobre el papel: dar al modelo el diseño original y pedirle que aumentara el rendimiento, medido en instrucciones por segundo. Un diseño que fallaba una comprobación o que usaba más de 16 veces el área original recibía un cero.
Con un presupuesto comparable de unos 112.000 tokens por ejecución, GPT-6.2 Astra obtuvo la mayor puntuación media en ambos núcleos, y GPT-6.1 Sol superó a GPT-5.6 Sol en los dos casos. Sobre el PicoRV32 ya existente, la puntuación de GPT-6.2 Astra con ese presupuesto era aproximadamente el doble que la de GPT-6 Astra. En una segunda variante del experimento, en lugar de mejorar un diseño existente, los modelos recibían solo requisitos escritos y plantillas, y decidían cómo circulaba el dato por el núcleo y cómo se dividía el trabajo en etapas. A igual presupuesto, los cinco modelos mostraron una puntuación más alta al diseñar desde una especificación que al intentar mejorar el diseño existente, algo que los autores explican en parte porque así el modelo puede prescindir de funciones como los contadores de rendimiento, que apenas influyen en las cargas de trabajo del test.
El ejercicio también sirve como advertencia: El propio OpenAI reconoce que los números son menos representativos de la realidad de un chip de producción: los diseños desde especificación no estaban obligados a incluir todas las funciones originales, el límite de área era una regla del test y no una restricción de física, y no se comprobaba el timing después de la síntesis física. Aun así, el volumen es imponente: la evaluación completa incluyó 9.881 ejecuciones puntuadas entre las dos tareas, los dos núcleos y todos los presupuestos de tokens.
El movimiento tiene una segunda pata, todavía más interesante a medio plazo. OpenAI está entrenando GPT-Synopsys, un modelo nuevo, en colaboración con Synopsys, para usar las herramientas EDA de forma similar a como lo haría un diseñador de chips experto. Si esa pieza funciona, la frontera deja de estar en el modelo suelto y pasa a estar en el modelo que conoce la herramienta: el que sabe cómo lanzar una síntesis, cómo interpretar un informe de tiempos y cómo iterar sin romper la equivalencia funcional.
- OpenAI publica como sus modelos reescriben RTL en SystemVerilog y validan cada cambio con herramientas de Synopsys.
- En su chip de inferencia Jalapeño, los cambios propuestos redujeron el área de celdas estándar un 13 % en la unidad vectorial y un 10 % en la matriz, ya validados en silicio.
- Con AMD, la colaboración alcanzó mejoras de hasta un 14 % en PPA sobre la IP de GPU insignia, y AMD ya envió a fabricación un diseño con esos cambios.
- En las pruebas con los núcleos RISC-V PicoRV32 e Ibex, GPT-6.2 Astra fue el modelo con mejor puntuación, con unas 9.881 ejecuciones evaluadas.
- OpenAI y Synopsys están entrenando GPT-Synopsys, un modelo que usará las herramientas EDA como un diseñador de chips experto.
Lo que importa aquí no es el 14 %, sino dónde está la responsabilidad. Durante años, la mejora de un chip la firmaba un equipo de diseño con meses de simulación y revisiones de equivalencia funcional. Si un modelo reescribe el RTL y la verificación la hace la misma herramienta que usa el ingeniero, el control de calidad se desplaza: el nuevo control es la validación contra la especificación, y eso es un problema distinto al que resolvían los Equivalence Checks de siempre.
Para quien opera infraestructura, hay una lectura práctica. Un 14 % de PPA en la GPU insignia de AMD, validado por el propio fabricante y ya incorporado en un diseño enviado a fabricación, se convierte en energía por token en el rack. En centros de datos donde la potencia y la refrigeración marcan la diferencia entre rentar o no, ese punto porcentual se nota en la factura. Pero la contrapartida es clara: si el silicio incluye cambios propuestos por un modelo, la cadena de suministro de tu hardware incorpora una dependencia en un componente no determinista y, sobre todo, en un proveedor. El silicio ya depende de fundiciones en Asia; depender además del comportamiento de un modelo de OpenAI en el diseño de tu GPU es otra categoría de riesgo, con distinta naturaleza.
También hay una lectura de red y de operaciones que me parece la más interesante a corto plazo. Si el diseño de hardware mejora a ritmo de un año de progreso en cinco meses, la consecuencia no es tanto que el chip sea mejor, sino que el ciclo de refresco de un clúster se acorta y la planificación de capacidad se vuelve más difícil. Comprar, integrar, validar y operar el silicio nuevo deja de ser un proyecto de años y se parece cada vez más a una actualización de software. Eso tiene una lectura positiva: hardware y software se parecen cada vez más. Y una lectura incómoda: la ventana de amortización de una inversión en GPU se acorta, y las métricas de utilización por vatio pasan a importar tanto como el precio de compra.
En resumen: es un resultado técnicamente serio, verificado en silicio y con un socio industrial que lo respalda, no un experimento de laboratorio. Lo que me queda como duda no es si el modelo puede escribir un multiplier mejor, sino quién responde cuando un chip vendido durante años arrastra un error de equivalencia funcional que ninguna prueba de regresión del cliente detectó a tiempo.
Referencia y documentación original: OpenAI.
https://openai.com/index/advancing-chip-design-with-our-models
También te puede interesar
Lambda lleva la óptica empaquetada al centro de la red de IA
Lambda usa switches con óptica empaquetada NVIDIA Photonics (CPO) para conectar racks GB300 NVL72 que suman más de 10.000 GPU en una fábrica de IA a escala.
El Apple Watch que escucha siempre y borra el audio al instante
Siri Recap del Apple Watch Ultra 4 resume conversaciones ambientales sin transcripción visible y borra el audio original tras procesarlo.
Crisis de memoria: Intel se hunde 28,6% y sus accionistas demandan
Accionistas demandan a Intel, a Lip-Bu Tan y a David Zinsner por supuestas declaraciones enganosas entre el 23 de julio y el 29 de octubre.