OpenAI pone agentes a cazar las regresiones que ralentizan ChatGPT
OpenAI ha construido Performance Factory, un sistema autónomo que usa agentes de Codex dentro de su nube para investigar y corregir regresiones de rendimiento de ChatGPT.
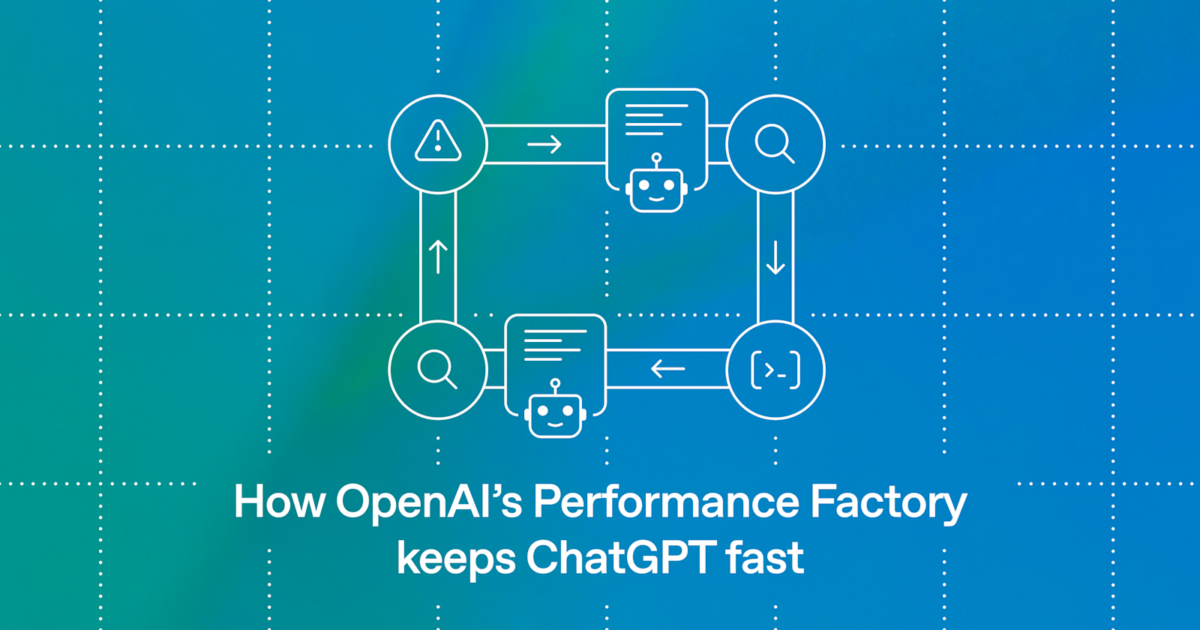
La fábrica de rendimiento que depura ChatGPT sola
Hay un problema que casi nunca sale en las presentaciones de producto: ChatGPT se ralentiza. No por un corte de red ni por una caída de servidores, sino por la regresión más difícil de detectar, ese cambio de código que alarga la respuesta del primer token sin que nadie se dé cuenta hasta que las métricas de uso se mueven. OpenAI acaba de publicar cómo lo ha resuelto: una fábrica de rendimiento, un sistema autónomo que usa Codex para investigar y corregir dentro de su propia infraestructura.
La clave está en el punto de partida. Antes de Codex, los ingenieros revisaban a mano métricas y registros, comparaban trazas, depuraban máquinas en vivo y leían el código para encontrar un origen. Con los años, el equipo acumuló más de treinta herramientas internas para reconstruir cada incidente. Era un trabajo lento que dependía de conocer cada servicio.
Con Codex como compañero, el salto vino de poder preguntar en lenguaje natural, «¿por qué esto se ha ralentizado?», y obtener en minutos una investigación que antes costaba días. La fábrica pasó de acompañar al ingeniero a trabajar por su cuenta.
Alertas, tareas y revisores adversarios
El servicio se llama Performance Factory y funciona en la nube, con tareas explícitas y estados visibles. Los ingenieros definen flujos de trabajo y escriben las instrucciones que ejecutarán los agentes de Codex. El primero, el Regression Workflow, se abre cuando salta una alerta: un agente investiga la ralentización, registra lo que encuentra y propone una corrección. Tras el despliegue, otro agente recoge la misma tarea y comprueba si el rendimiento volvió a su línea base.
Los números son concluyentes: en algo más de tres meses, el Regression Workflow registró más de 1.700 investigaciones y llegó a la causa raíz en más de 600 casos, diecisiete al día. El estado de la tarea vive fuera del contexto de cualquier agente, de modo que otro agente o persona puede retomar el trabajo.
El detalle interesante es la revisión adversarial. Al principio los agentes se quedaban en la primera explicación plausible y algunos diagnósticos resultaban ser incorrectos. La solución fue añadir una sesión separada de Codex cuyo único trabajo es intentar refutar el diagnóstico: comprobar los supuestos, probar contrahechos y verificar que las peticiones no expuestas al despliegue permanecieron sanas. En un caso, un agente atribuyó unos fallos a errores en la descarga de imágenes, pero el revisor vio que el servicio que localizaba los archivos ya se había recuperado mientras las peticiones seguían fallando, y la investigación se reabrió.
La precisión medida en una revisión manual de 100 propuestas de causa raíz fue del 70 % de aciertos, con el 30 % restante necesitando más ajuste. Y el paso más difícil no es encontrar la causa sino corregirla: han visto casos en los que el cambio propuesto era más complicado de lo necesario o introducía problemas nuevos. Cada arreglo pasa también una revisión adversarial, y hay cambios que exigen decisiones de arquitectura, como una caché que mejora el rendimiento pero introduce datos obsoletos.
De la alerta al diagnóstico
El flujo funciona con una disciplina casi policial. Cuando salta una alerta, el agente determina qué métricas empeoraron, cuándo empezaron a empeorar y qué peticiones se vio afectadas. La alerta salta al cruzar un umbral, pero la regresión puede haber empezado horas antes, así que el agente retrocede en los datos para encontrar el primer momento en que la métrica se ensombreció. Después compara grupos de peticiones: no es lo mismo que las similares se hayan vuelto más lentas que el hecho de que se esté sirviendo más peticiones que ya eran lentas de por sí, y esa distinción apunta a causas distintas. Localizado el cuándo y el dónde, examina despliegues y banderas, lee el código y usa registros y trazas para comprobar si puede explicarlo.
El agente corre en la nube, dentro de la red de OpenAI, con acceso a los repositorios de código y a las herramientas de observabilidad de los ingenieros: métricas, registros, trazas, perfiles de CPU y capturas de memoria. Corre bajo una identidad de servicio, de modo que sus permisos se acotan y se puede ver qué acciones salieron de los agentes. La nube permite trabajar en paralelo sin depender del portátil de nadie. Cuando una tarea debe esperar, el agente se suscribe a eventos, como un comentario de revisión o una integración continua fallida, y el bucle se la entrega cuando llega.
La verificación del resultado es la última pieza. Tras el despliegue, un agente comprueba si el rendimiento se recuperó. Si solo se recuperó a medias, resuelve la regresión original y abre una tarea nueva para la ralentización restante, que puede tener otra causa. Si no hubo mejora, devuelve el caso a investigación.
Evaluar al evaluador
Lo más interesante no es el sistema, sino la disciplina con la que OpenAI mide si funciona. El texto es explícito: cambiar una habilidad o subir de modelo puede mejorar unos casos y empeorar otros, así que hay que probar el impacto antes de desplegarlo. Para ello separan dos evaluaciones: cómo investiga el agente y cómo resume sus hallazgos.
Para lo primero usan pruebas retrospectivas contra incidentes reales ya resueltos. Cada incidente se convierte en un caso de prueba que se puede volver a ejecutar, con la señal original y sin los detalles que darían la respuesta. El agente tiene acceso limitado al código y a la telemetría de producción, pero no puede usar notas de investigaciones anteriores ni leer el informe del incidente, y revisan la transcripción para detectar contaminación del test. Puntúan por separado el acierto sobre cuándo empezó el problema y sobre qué despliegue culpar: son fallos distintos.
Para lo segundo usan instantáneas de tareas guardadas, porque resumir no depende de métricas ni trazas que caducan. Un evaluador separado comprueba si alguien ajeno al sistema entiende qué pasó y si el paso propuesto está respaldado por las pruebas.
Y hay un detalle familiar para cualquier ingeniero de operaciones: los propios agentes necesitan monitorización. Un perfilador roto o un permiso ausente pueden impedir a un agente verificar qué causó una ralentización, y esos fallos son difíciles de detectar en el informe final. Por eso ejecutan cada día un agente que revisa los registros recientes en busca de errores de herramienta o de acceso, y usan la propia fábrica para repararse.
Todavía no saltan de forma preventiva: el flujo arranca cuando salta una alerta, pero OpenAI trabaja en que los agentes exploren los datos que ya recogen y abran ellos mismos la tarea al detectar una regresión que las alertas no ven.
OpenAI ha construido Performance Factory, un sistema autónomo que usa agentes de Codex dentro de su nube para investigar y corregir regresiones de rendimiento de ChatGPT.
En algo más de tres meses, su Regression Workflow ha registrado más de 1.700 investigaciones y determinado la causa raíz en más de 600 casos, unas 17 al día.
El flujo va de la alerta a la causa raíz, la propuesta de arreglo, la revisión humana y la verificación, con un segundo agente que refuta el diagnóstico.
En una revisión manual de 100 propuestas de causa raíz, el 70 % se consideraron precisas; arreglar bien sigue siendo más difícil que encontrar el problema.
OpenAI además construye pruebas retrospectivas contra incidentes ya resueltos y un evaluador separado para medir si las mejoras del agente sirven.
Para quien lleva redes o telecomunicaciones, esta historia tiene dos lecturas. La primera, evidente, es que la observabilidad se ha convertido en un problema de agentes y no solo de personas. Cuando el servicio se instrumenta bien, con métricas, trazas y perfiles consultables, un agente trabaja con el mismo material que usaba el ingeniero de turno. Sin esa instrumentación, el automatismo no hace nada.
La segunda lectura tiene que ver con el reparto de responsabilidades. OpenAI mantiene un humano en el bucle en el punto que más duele, la fusión del código. El agente investiga, propone y hasta abre la solicitud de cambios, pero alguien con criterio decide qué se despliega. Ese diseño no es conservadurismo, es la consecuencia de medir el propio sistema: un 70 % de aciertos significa que una de cada tres hipótesis queda mal encaminada. Los errores no se esconden, se miden y se corrigen.
También me quedo con el agente diario que vigila los errores de herramienta de los otros agentes: un sistema que monitoriza servicios pero no se monitoriza a sí mismo acaba fallando en silencio.
Lo que no convence es el hype. Ni el 70 % ni los 1.700 casos significan que un agente entienda la arquitectura como su autor: solo que con las herramientas correctas y los datos donde toca, llega antes y con más cobertura. La diferencia real está en la revisión adversarial, barata comparada con el incidente que evita. Es un patrón copiable en cualquier operación de red: un detector automático, un revisor que intenta tumbar la hipótesis y una decisión final con nombre y apellidos.
Referencia y documentación original: OpenAI.
https://openai.com/index/how-openai-performance-factory-keeps-chatgpt-fast
También te puede interesar
Claude Code se bloquea al tapar los agujeros de tu servicio
El ingeniero estonio Herman Ounapuu pidió a Claude Code que corrigiera un fallo de seguridad de una línea en su propio producto y el modelo se detuvo.
OpenAI despliega Daybreak Red para investigar en ciberseguridad sin perder el control
OpenAI publica la arquitectura de referencia de Daybreak Red, una guía de once páginas para desplegar sus modelos de ciberseguridad de forma supervisada y aislada.
Grok Bot se activa solo, accede a tu Slack de madrugada y lo niega
Dos empleados con Grok Bot instalado en sus portátiles vieron 31 accesos no autorizados en cinco días a calendarios, correo, Slack y GitHub, sin haberlo pedido.