IBM lleva sus modelos de series temporales a Confluent y los ejecuta en CPU
IBM y Confluent han cerrado una alianza que mueve la inteligencia predictiva al flujo de datos en vivo. La familia de modelos de series temporales TTM (Time Series Transformer), distribuida bajo el nombre Granite en Hugging Face y con más de 50 millones de descargas, ya está disponible de forma nativa dentro de Confluent: se invoca desde Apache Flink usando SQL y devuelve previsiones, detección de anomalías e inteligencia semántica mientras los eventos fluyen, sin salir de la canalización.
El punto interesante para quien despliega infraestructura es que estos modelos corren sobre CPU, sin necesidad de GPU. En Confluent Cloud son gestionados por completo y no hay nada que instalar; en instalaciones locales, los modelos se ejecutan dentro de la propia infraestructura usando Confluent Platform para Apache Flink. Eso elimina la dependencia de clústeres de GPU dedicados y simplifica el despliegue donde el consumo de energía y el coste de la capacidad importan.
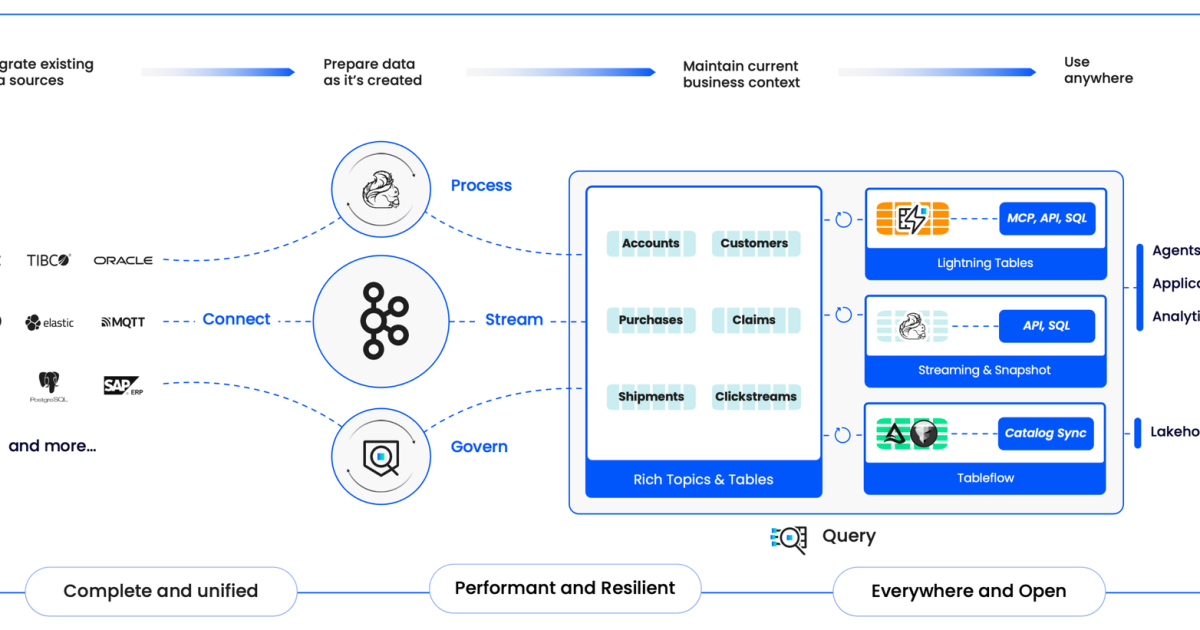
El concepto que propone IBM es el «Streamhouse»: capturar, procesar, gobernar y servir de forma continua el contexto actual del negocio, en lugar de depender de procesos batch periódicos. La plataforma de streaming de Confluent combina cinco capacidades —conectar, transmitir, procesar, gobernar y consultar— mientras que Apache Flink transforma y enriquece los datos en movimiento y las Lightning Tables dan acceso de baja latencia al estado actual. Sobre esa capa, los modelos de series temporales aportan el poder predictivo, y pueden combinarse con modelos de lenguaje, modelos estadísticos y sistemas de ML especializados bajo una misma orquestación.
Los casos de uso que describe el artículo van de la línea de producción a la bolsa. En una planta de helado, un modelo TTM preentrenado lee la telemetría SCADA y las mediciones de calidad cada 10 minutos, y anticipa con cuatro horas de antelación qué porcentaje de bandejas quedará fuera de especificación, con su rango probable; cuando esa previsión cae por debajo del objetivo, un proceso de optimización puntúa combinaciones de temperatura de congelación y caudal de aire antes de tocar la línea, y el operador aprueba los setpoints recomendados. El mismo esquema se aplica a hornos, secadores, hornos de cemento y molinos. En banca, la detección de anomalías sirve para evaluar pagos con tarjeta, donde cada tarjeta tiene su propia normalidad; en retail y transporte, la planificación de cadena de suministro trabaja a nivel de referencia, tienda y hora; y en trading, el modelo ayuda a dimensionar la orden al ritmo del mercado.
La ventaja de los modelos fundacionales de series temporales es que evitan entrenar un modelo por cada serie: un modelo preentrenado sirve como punto de partida común y, según la tarea, se puede ajustar en fino o combinar su salida con la lógica de negocio. Las predicciones se refrescan dentro del propio flujo a medida que llegan observaciones nuevas, siempre que lo permita la configuración de la canalización, y las señales se enrutan a las aplicaciones operativas para que se combinen con reglas y con el criterio humano.
- IBM y Confluent integran de forma nativa los modelos de series temporales TTM / Granite en Confluent, en la nube y en instalaciones locales.
- Se invocan desde Apache Flink con SQL para obtener previsión, detección de anomalías e inteligencia semántica en tiempo real.
- Los modelos corren sobre CPU, sin GPU, lo que reduce la infraestructura dedicada y simplifica el despliegue.
- La familia Granite de modelos de series temporales acumula más de 50 millones de descargas en Hugging Face.
- Casos reales: control de calidad en planta de helado, fraude con tarjetas, planificación de inventario y dimensionado de órdenes de bolsa.
Desde el punto de vista de un técnico de redes y telecomunicaciones, lo verdaderamente interesante aquí no es el modelo en sí, sino el cambio de paradigma en la infraestructura: la inferencia se acerca al dato y se ejecuta en la CPU, dentro de la misma canalización que ya mueve el tráfico de eventos. Eso significa menos saltos de red, menos copias de datos entre el lakehouse y el clúster de GPU, y una latencia mucho más baja entre la anomalía y la acción correctiva, que es exactamente lo que se mide en una red: el tiempo entre el evento y la respuesta.
El argumento de «sin GPU» es el que más me convence. En la mayoría de organizaciones la parte más amplia del presupuesto de IA está en la capacidad de inferencia, no en el entrenamiento, y Confluent con Flink permite reservar CPU ya existentes para cargas de predicción ligera en lugar de comprar aceleradores dedicados que luego quedan ociosos. Para un banco, una cadena de retail o una planta industrial, esto baja la barrera de entrada de forma notable.
Matices: el artículo viene de IBM Research y describe su propia arquitectura, así que las cifras de adopción y los casos de éxito deben leerse como argumentos de marketing hasta que haya evidencia independiente. Además, ejecutar inferencia dentro de la canalización de streaming tiene un coste operativo real: hay que dimensionar el pipeline para los picos de carga, vigilar la latencia del clúster Flink y evitar que una tarea de inferencia bloquee el flujo de eventos. En un entorno con SLA estrictos, esto no es trivial. Aun así, la dirección es correcta: la IA de producción va a dejar de ser un servicio aparte al que se llama por API y va a ser una función más dentro del flujo de datos.